Cómo construir un índice de jugadores eficaz
Cómo elegir métricas y ponderaciones, y evitar los riesgos que pueden distorsionar tus clasificaciones y llevarte a los jugadores equivocados.
Has identificado un hueco en la plantilla: un mediocentro organizador que se asocie por detrás de la línea de presión. Pero pasar de esa necesidad a la recomendación final del equipo de scouting es un camino largo. En este artículo analizaremos una etapa clave y fundamental de ese proceso: la construcción de un índice de jugadores.
Repasamos los pasos necesarios para construir un índice de jugadores eficaz, desde la definición del perfil, un subconjunto específico de métricas y sus ponderaciones asignadas, hasta los tres riesgos que hay que vigilar.
Dónde encaja en el proceso de scouting
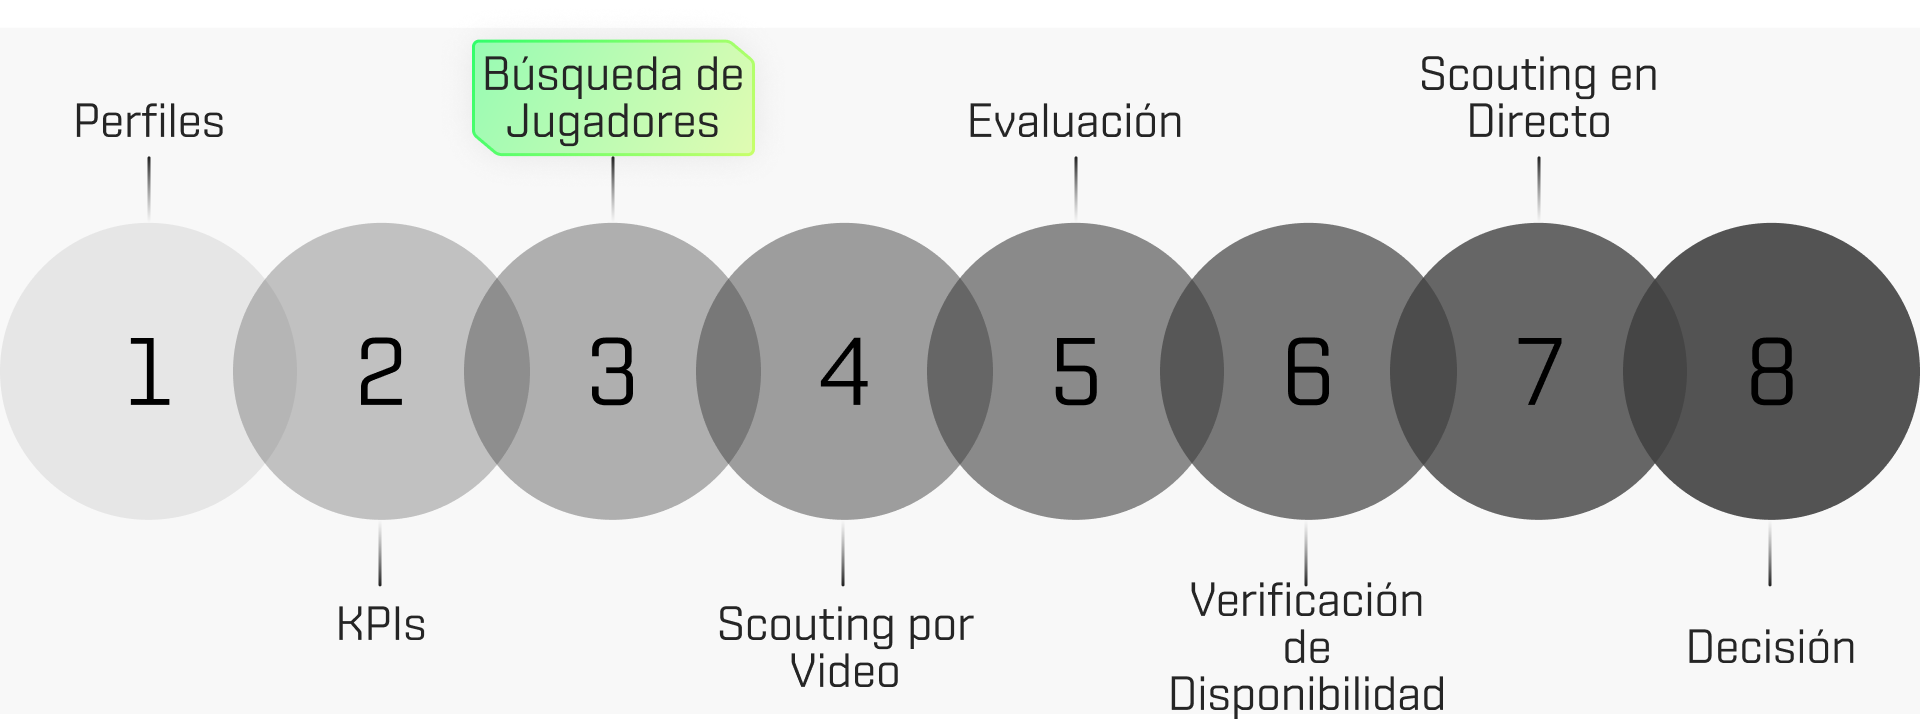
En un proceso de scouting estándar, la construcción de un índice se sitúa en la fase de búsqueda de jugadores. Es el momento en el que necesitas reducir el universo de jugadores a una lista corta de opciones viables. Una mala elección de las métricas del índice o una distribución desequilibrada de las ponderaciones entre ellas puede descartar prematuramente a jugadores que encajan o dejar pasar a la siguiente fase a otros que no son adecuados.
Qué es un índice y cómo construirlo
Un índice es un único número construido a partir de la suma ponderada de métricas normalizadas. Los índices se utilizan mucho en el fútbol para reducir un conjunto amplio de jugadores a una lista corta de candidatos potenciales que encajan con un perfil objetivo.
Para construirlo, necesitas tres cosas:
- Un perfil objetivo (por ejemplo, un "central con buena salida de balón").
- Un subconjunto de métricas que se corresponda con los atributos requeridos para ese perfil objetivo.
- Unos pesos asignados a cada métrica.
En principio, suena bastante sencillo. El problema es que la relevancia estadística de un índice no siempre se traduce en un impacto futbolístico real.
Un índice es, en esencia, matemáticas. Toma números, los normaliza, los suma según los pesos asignados y produce una clasificación. Aunque ese ejercicio siempre dará un resultado ordenado, eso no significa necesariamente que la diferencia entre dos jugadores muy alejados en el ranking sea relevante en términos futbolísticos prácticos. Hay que tener en cuenta la elección de las métricas y cómo se distribuyen en toda la muestra.
A continuación, explicaremos tres posibles riesgos a vigilar al construir un índice: por qué importan, cómo pueden distorsionar tus resultados y cómo evitarlos.
Riesgo 1: Métricas individuales con poca capacidad de discriminación
La primera pregunta que hay que hacerse sobre cualquier métrica individual antes de añadirla a tu índice es si realmente separa a los jugadores. Eso es justo lo que indica el coeficiente de variación (CV).
El CV es la desviación estándar de una métrica dividida entre su media y multiplicada por 100. Permite evaluar la dispersión de una distribución.
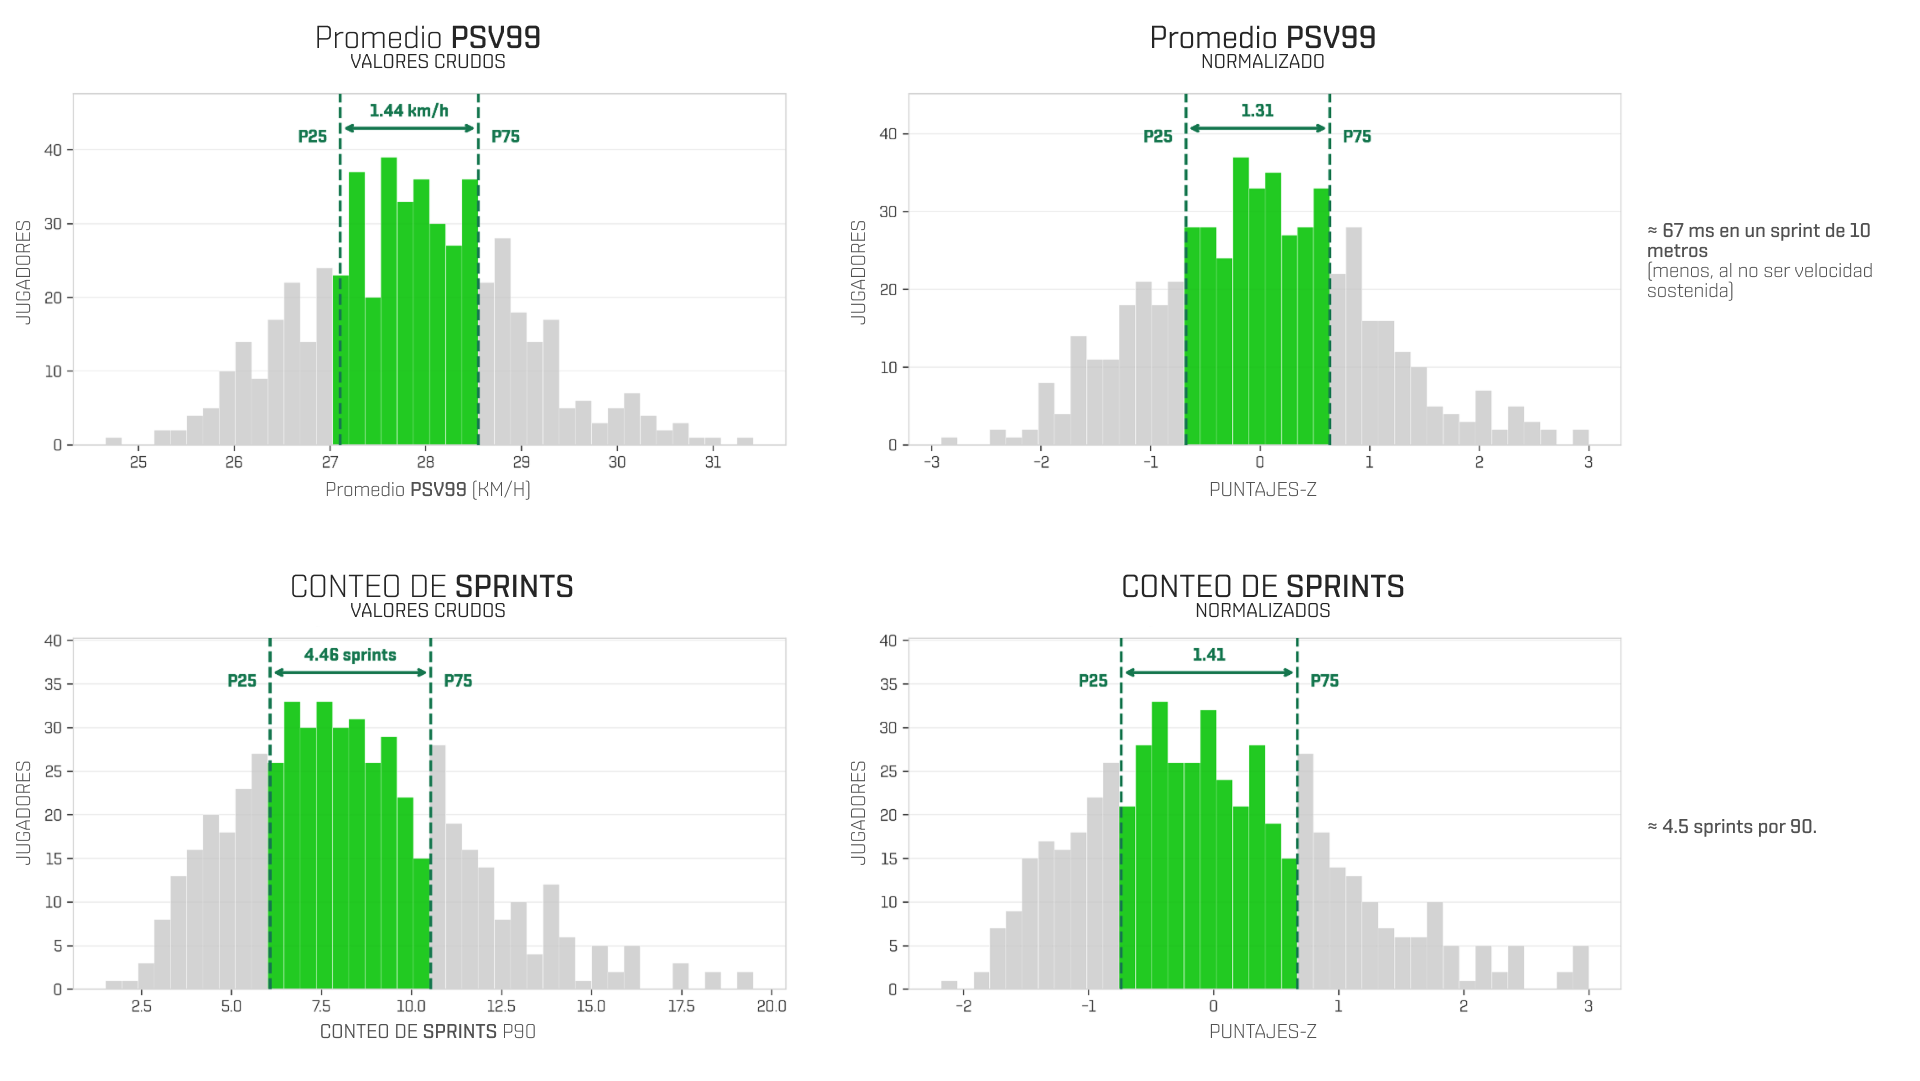
Un CV bajo significa que la mayoría de los jugadores puntúan cerca de la media, por lo que la métrica apenas separa a los jugadores. En el ejemplo siguiente, usando la PSV 99 – una métrica con un CV del 3,9% – una diferencia de 43 posiciones en el ranking resulta estar motivada por una diferencia de 86 milisegundos en un sprint de 10 metros: estadísticamente real, pero prácticamente imperceptible sobre el terreno de juego.
(La muestra utilizada en este artículo se compone de centrocampistas que hayan disputado al menos 5 partidos de 60 minutos en las cinco grandes ligas. Las conclusiones dependen de la muestra)
Por otro lado, el conteo de sprints p90, una métrica con una correlación de 0,81 con la PSV 99 y un CV del 37,6%, capta buena parte de la misma señal, pero separa mejor a los jugadores.
Para ilustrar aún más este punto, se puede ver que, aunque los gráficos siguientes muestran una diferencia similar entre los percentiles 25 (P25) y 75 (P75) tras la normalización, el de la PSV 99 indica solo una diferencia de 67 ms en un sprint de 10 metros (poco relevante a nivel futbolístico), mientras que el del número de sprints señala una diferencia de 4,5 sprints por 90 minutos (más relevante).
Aunque, por lo general, un CV más alto indica una mejor separación, en algunas ocasiones puede irse demasiado lejos y resultar engañoso. Tomemos como ejemplo los pases a través de 1ª Línea (por 30 TIP). Su CV del 100% se debe a la relación de la métrica con un rol muy específico del centro del campo. No separa bien a los jugadores: destaca solo a un pequeño puñado de "6" especialistas, mientras que la mayoría de los jugadores se concentran cerca de cero. Esto solo sería útil si estuvieras analizando específicamente a un "6" que reciben antes de la primera línea.
Como se puede ver arriba, una diferencia de tan solo 1,41 pases a través de 1ª Línea por 30 TIP provoca un vuelco de 88 posiciones, motivado por una métrica con una distribución extrema.
Una alternativa más fiable para una búsqueda más amplia son los pases a través de la línea MC, con un CV más manejable del 58,9% y una correlación de 0,64 con la métrica de la primera línea. Tras la normalización, los pases que rompen la primera línea muestran solo una diferencia de 0,83 entre P25 y P75, frente a 1,49 en el caso de los pases que rompen la segunda línea para la misma diferencia de ranking.
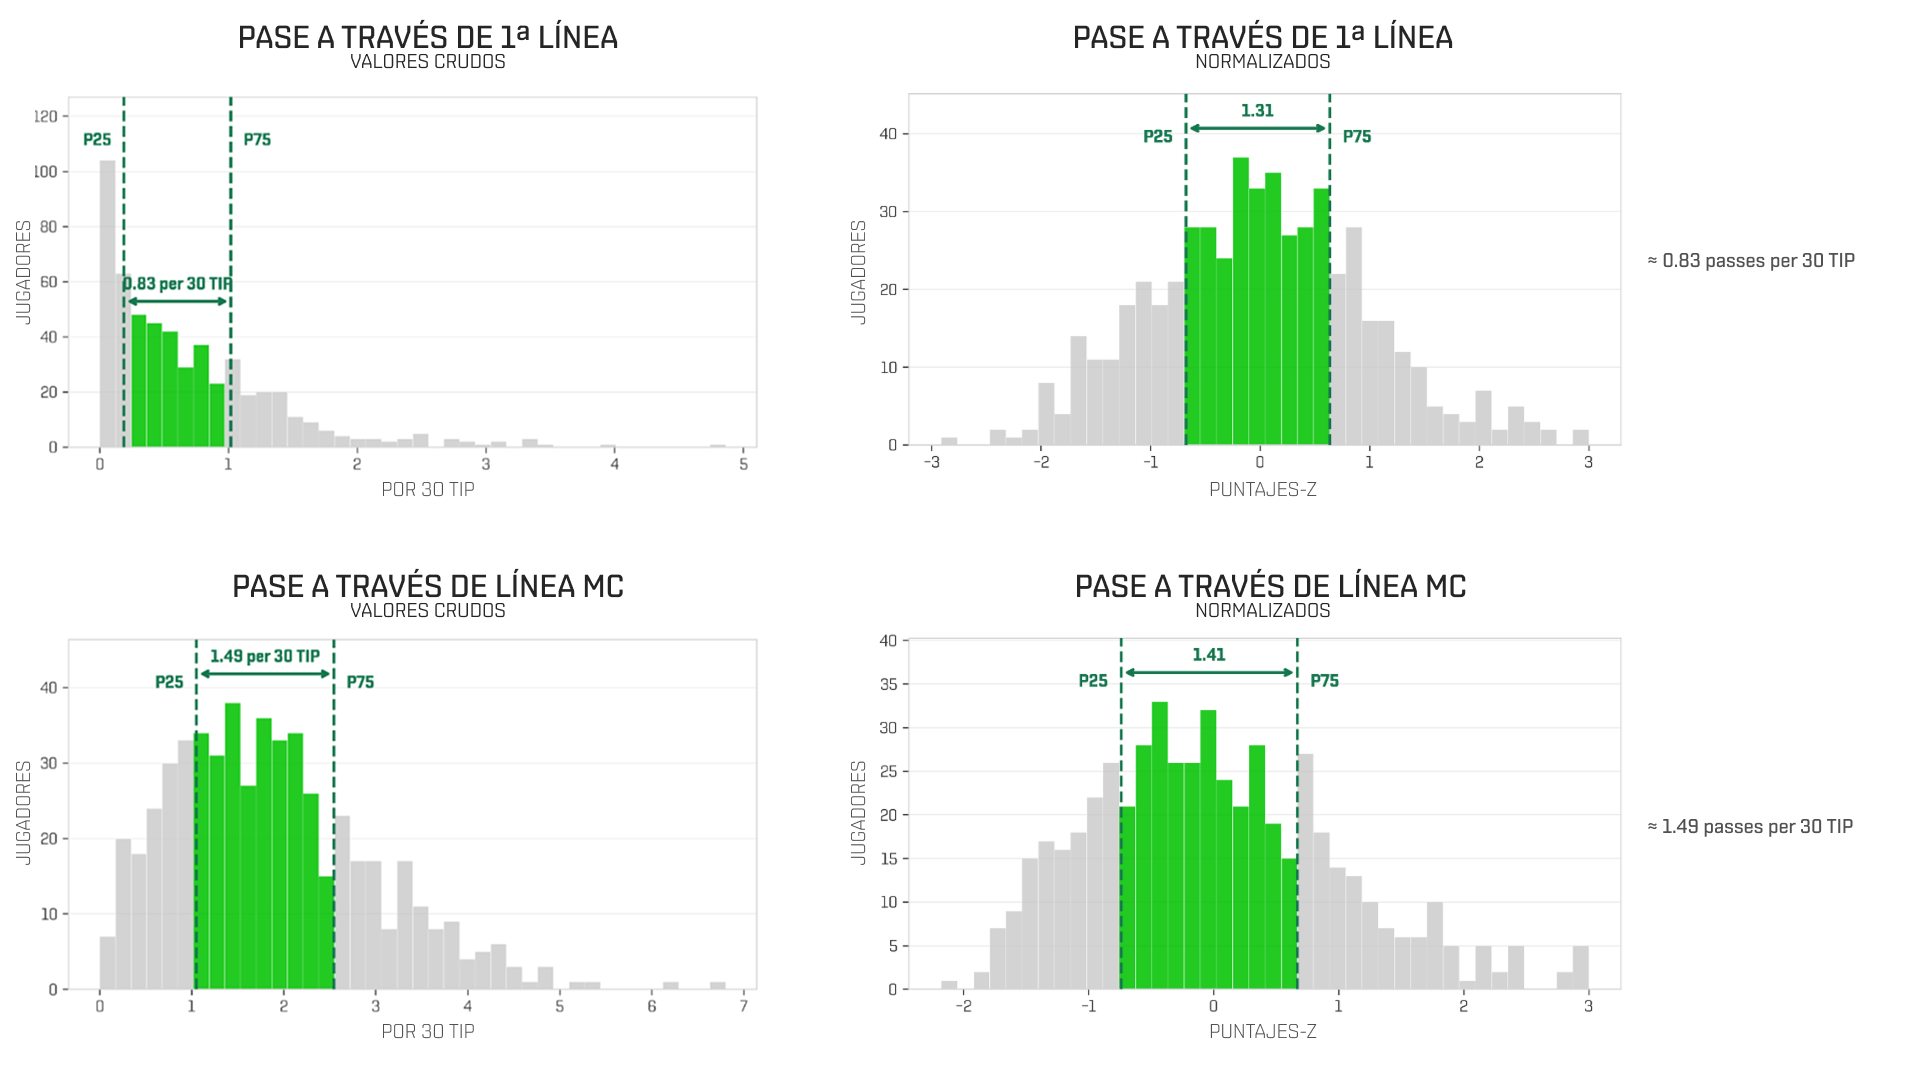
Evaluar la capacidad de discriminación de una métrica, tanto estadísticamente (mediante el CV) como en términos futbolísticos prácticos, es un paso crítico antes de incluirla en un índice. Elegir métricas con mayor poder de discriminación y que dependan menos de escenarios tácticos muy específicos ofrece una base más fiable para comparar jugadores de forma eficaz.
Riesgo 2: Métricas excesivamente correlacionadas
El poder de separación no es lo único a tener en cuenta al elegir tus métricas. La siguiente pregunta debería ser en qué medida dos o más de tus métricas están correlacionadas entre sí.
Por ejemplo, el conteo de acciones a alta intensidad (p90) y la distancia en alta intensidad (p90) se correlacionan en 0,966. En la práctica, es como si estuvieras incluyendo la misma métrica dos veces. El impacto de estas métricas correlacionadas en los resultados será mayor de lo previsto, duplicando el peso de un único atributo subyacente.
Si construyes un índice con, por ejemplo, cinco métricas, cada una pensada para representar el 20% de la puntuación final – una quinta parte para posesiones, otra para desmarques, otra para intensidad, etc.– y dos de esas métricas acaban midiendo en realidad la misma capacidad, el resultado queda descompensado.
A la inversa, una correlación negativa puede provocar un tipo de problema distinto. El conteo de acciones a alta intensidad (por 90) y los pases a través de la línea MC (por 30 TIP) se correlacionan en -0,51. Esto significa que, incluso entre los jugadores mejor clasificados, es menos probable encontrar jugadores que puntúan alto en ambas métricas a la vez. Si tu perfil objetivo realmente necesita ambas cualidades, debes esperar que tu grupo de candidatos realistas se reduzca de forma considerable.
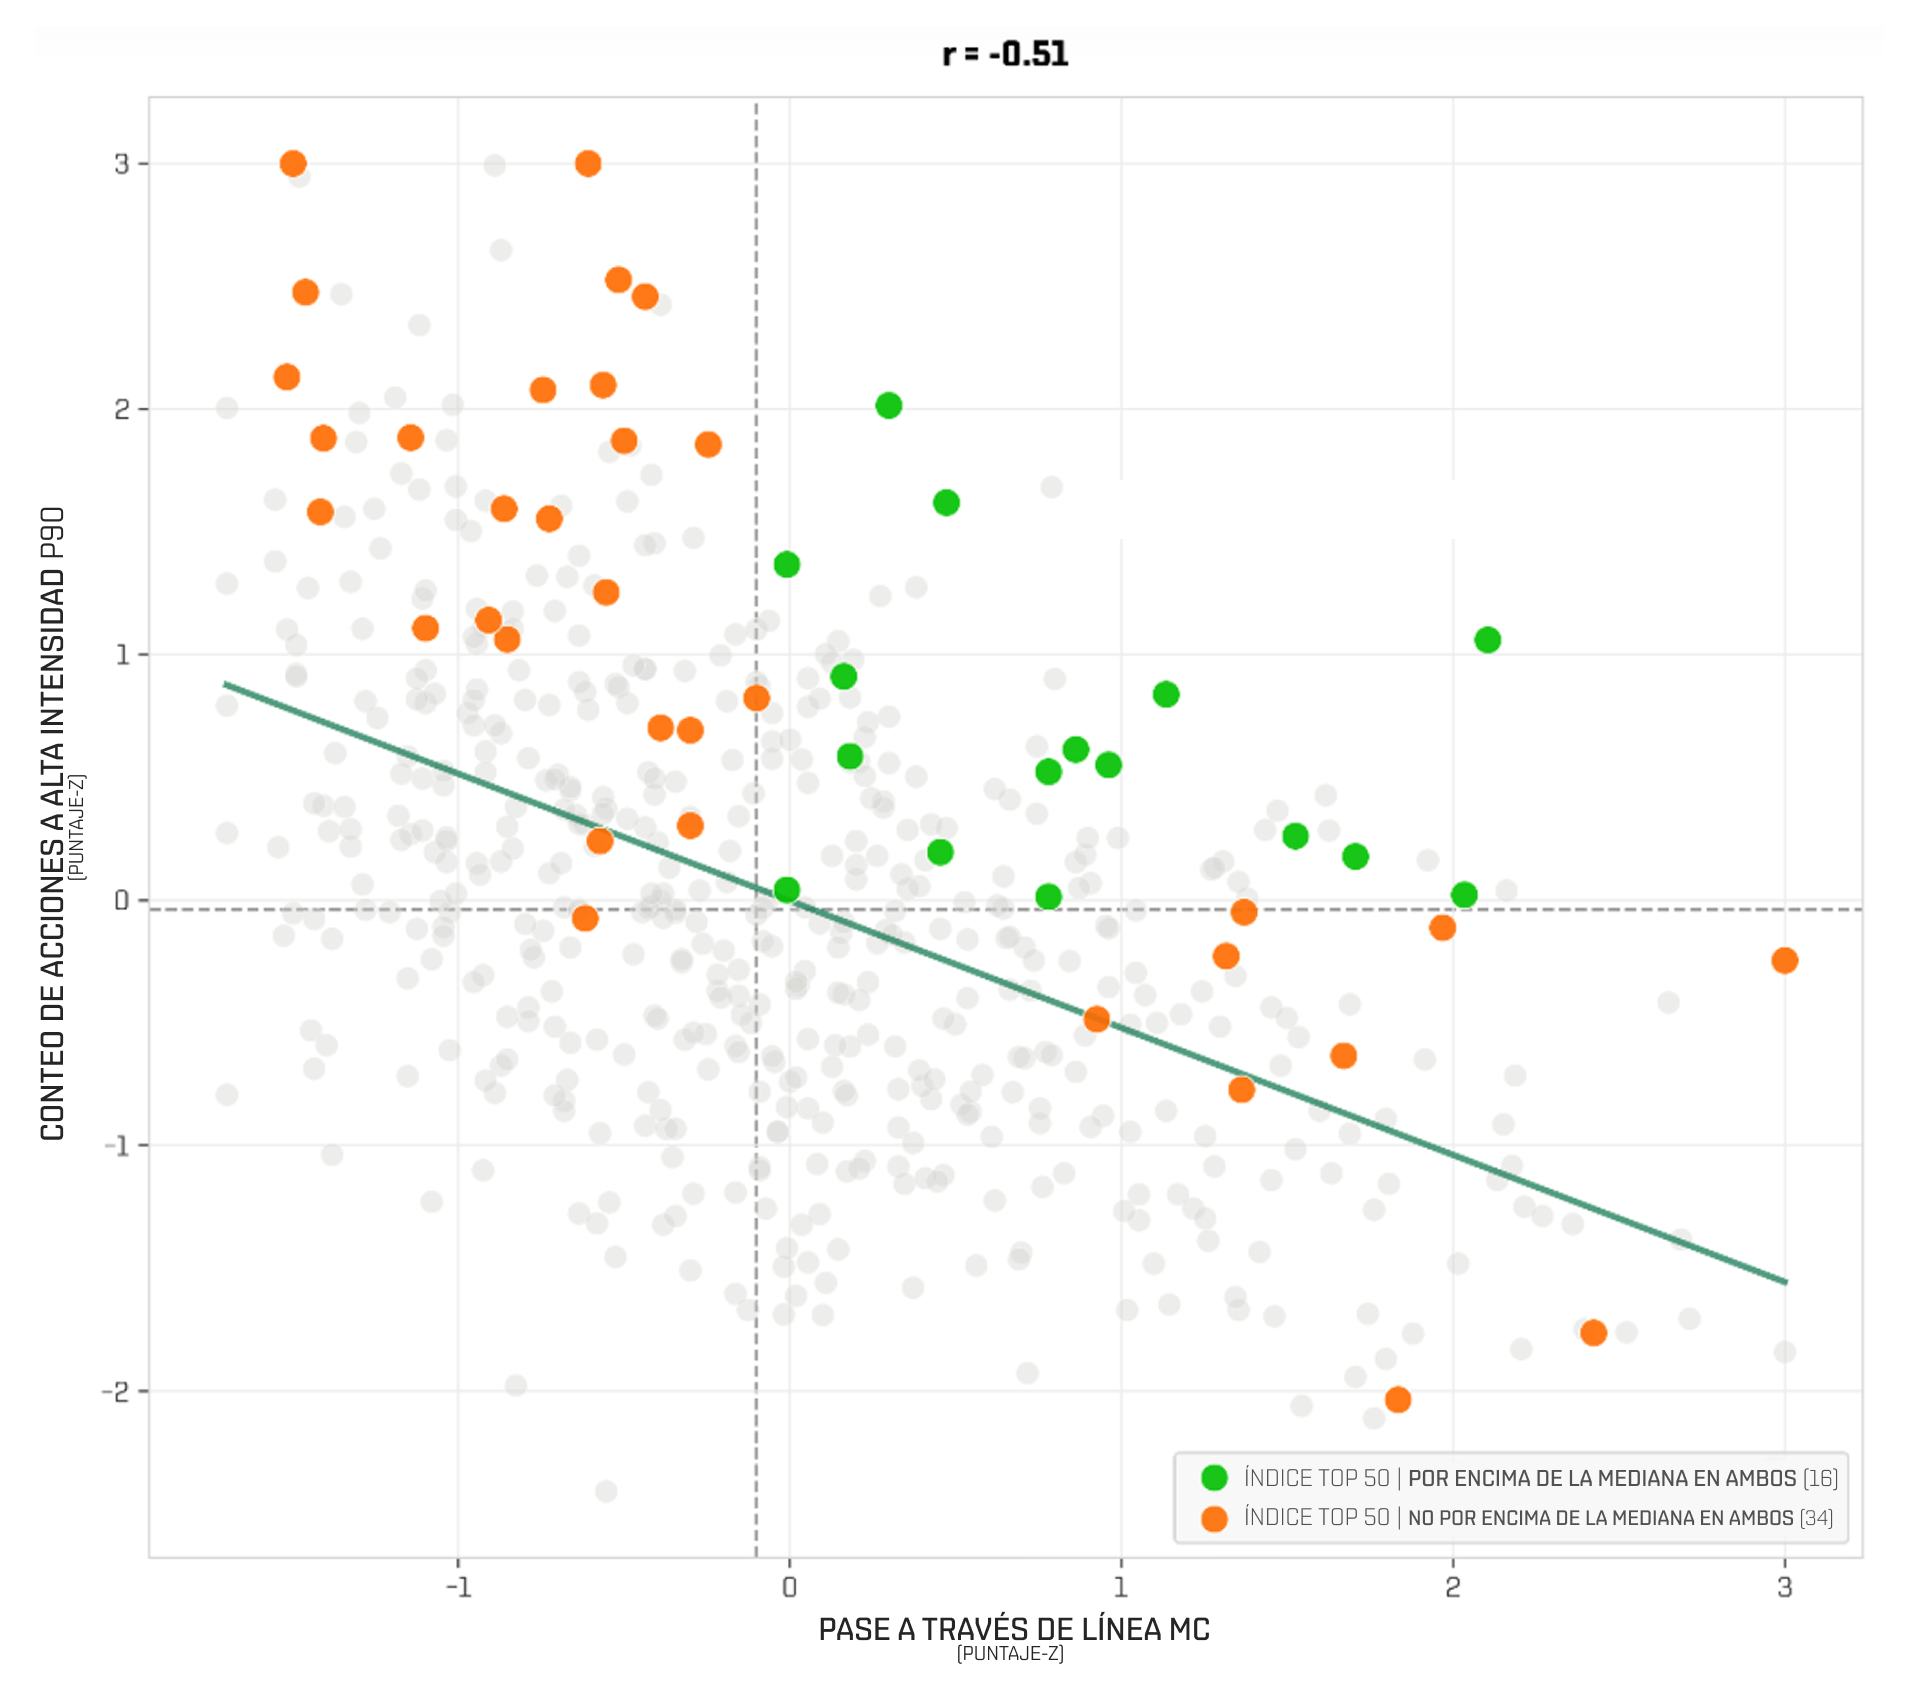
Por otro lado, esa escasez también puede leerse, en ocasiones, como una fortaleza. Encontrar perfiles que puntúan alto en ambas puede ser un hallazgo legítimamente poco frecuente y valioso, en el que podría merecer la pena centrarse.
Evaluar la correlación entre pares de métricas, ya sea positiva o negativa, es, de nuevo, un paso crucial. Una correlación positiva alta, en esencia, duplica una métrica y su peso, mientras que una correlación negativa fuerte puede traducirse en la búsqueda de combinaciones estadísticamente raras o incluso inalcanzables.
Riesgo 3: Demasiadas métricas
Aunque pueda resultar tentador pensar que añadir más métricas a un índice lo hará más completo, los datos demuestran lo contrario. Por lo general, cuantas más métricas incluyas, más se diluye la comprensión de qué impulsa la posición alta de un jugador en el ranking, y más puntos débiles mostrarán incluso los jugadores mejor clasificados.
El gráfico siguiente muestra a los 25 mejores jugadores en una serie de selecciones aleatorias de métricas (pesos uniformes, 100 conjuntos aleatorios por punto), y refleja qué proporción de las métricas de un índice queda por debajo de los percentiles 50, 75 y 90 a medida que crece el número de métricas, de cinco a veinte.
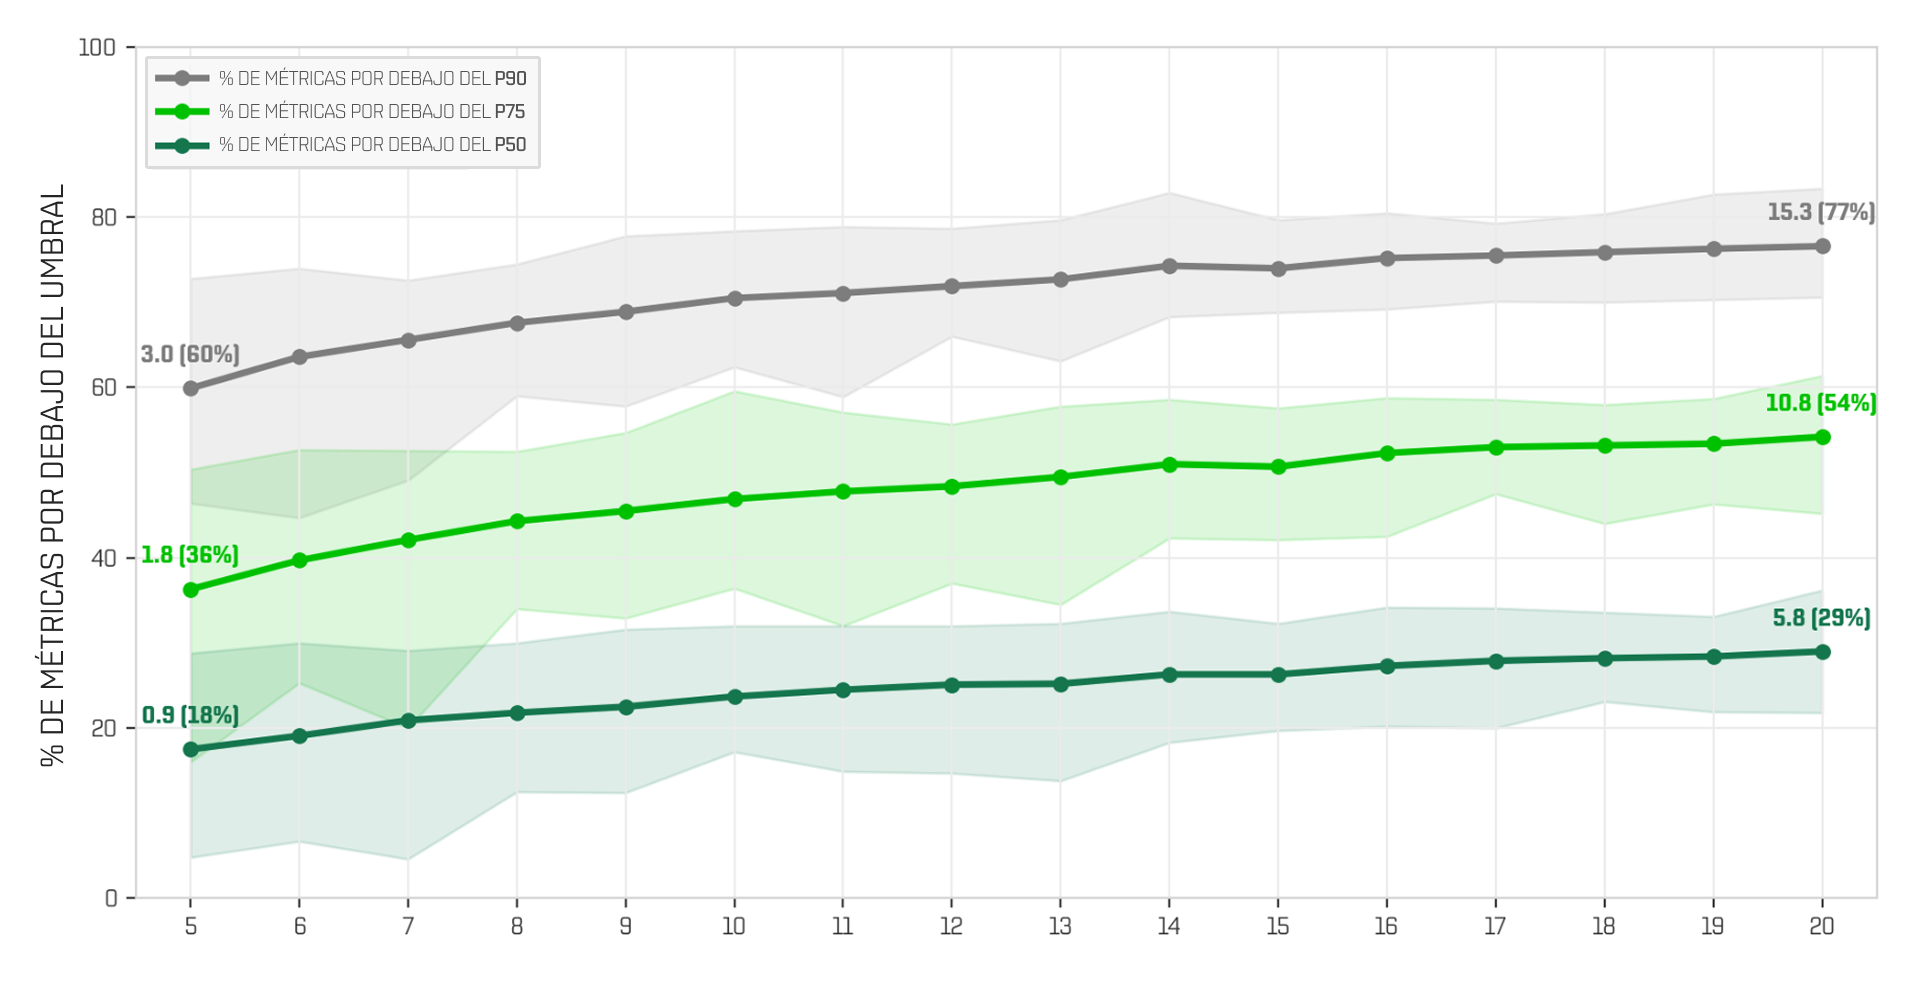
Con cinco métricas, el 18% de las métricas de un jugador del top 25 queda por debajo de P50, el 36% por debajo de P75 y el 60% por debajo de P90. Con veinte métricas, esas cifras suben al 29%, 54% y 77% respectivamente.
A continuación se puede ver cómo se traduce esto en una situación real. Este índice es muy parecido a uno que un usuario de prueba construyó en nuestra plataforma WebApp Lab, con 18 métricas distintas. Podemos deducir que conlleva un riesgo elevado de CVs y correlaciones perjudiciales (conteo de acciones y distancias), además de puntos débiles, debido al elevado número de métricas.
Y esto es lo que produce ese índice: el número 1 del ranking es de nivel élite en casi todas las métricas, pero presenta puntos débiles muy visibles. El número 34 no muestra ninguna señal de alarma: un perfil más estable, equilibrado y completo que el del jugador clasificado muy por encima de él. Si el encargo era encontrar al jugador más completo, es difícil argumentar que este sea el resultado buscado.
La misma desconexión vuelve a aparecer con esta solicitud que recibimos para un "6 organizador":
- Técnicamente bien, se ofrece para recibir en posesión y mantiene la calma bajo presión. Muy resistente a la presión. —> Opciones de pase (fase de Creación), Ratio de Retención bajo Presión Intensa.
- Pasador progresivo, muy eficaz en los pases al espacio en los tres tercios del campo. —> Pases a través de las tres líneas.
- Con conciencia táctica y capacidad para cambiar el punto de ataque mediante cambios de orientación.
- Con visión de juego para controlar el ritmo y equilibrar la retención del balón con el riesgo.
- Defensor inteligente, eficaz para tapar líneas de pase, reducir espacios e interceptar pases progresivos del rival.
- Físicamente capaz de cubrir grandes distancias para estar siempre disponible en posesión y para contrapresionar sin el balón. —> Distancia en alta intensidad, Presiones tras pérdida.
Incluso antes de construir un índice, se puede deducir que encontrar un perfil polivalente capaz de hacer todo esto, situado por encima del percentil 60 de su liga en las métricas mencionadas, por ejemplo, es extremadamente difícil.
¿El resultado? Solo un jugador de 541 cumplía ese listón.
El enfoque alternativo aquí sería centrarse únicamente en lo que más importa en la fase de lista corta, con menos requisitos y la ponderación adecuada, y evaluar el resto de atributos más adelante en el flujo de trabajo de scouting.
Reflexiones finales
Construir un índice de jugadores es una de las formas más eficientes de moverse por un conjunto amplio de jugadores en la fase de búsqueda. Sin embargo, conlleva sus propios desafíos. Y, al ser una de las etapas fundamentales de un proceso de scouting, requiere un nivel especial de rigor. Una mala configuración en este punto puede hacer que un candidato sólido quede descartado antes de que nadie llegue a verlo jugar.
Es fundamental entender qué mide realmente cada métrica que lo compone, cómo se relacionan entre sí, y qué se sacrifica cada vez que se añade una nueva.
Ir más allá con los datos de SkillCorner
Si quieres saber más sobre cómo los datos de SkillCorner y nuestra plataforma fácil de navegar, WebApp Lab, pueden mejorar y acelerar tu proceso de scouting, ponte en contacto con nosotros hoy mismo.